BACKPROP LAB
Ein neuronales Netz beim Lernen zusehen.
Im Browser, auf Android, iPhone, iPad und Mac · deutsch und englisch · keine Konten, keine Werbung, kein Tracking · alles wird auf dem Gerät gerechnet
Was zu sehen ist
Punkte in der Ebene gehören zu zwei Klassen. Das Netz beginnt mit zufälligen Gewichten, rät, misst seinen Fehler und verstellt sich ein wenig in die Richtung, die den Fehler kleiner macht. Das ist Backpropagation — und der ganze Zweck hier ist, dass man ihr dabei zusehen kann.
Eine Kachel auf jedem Neuron
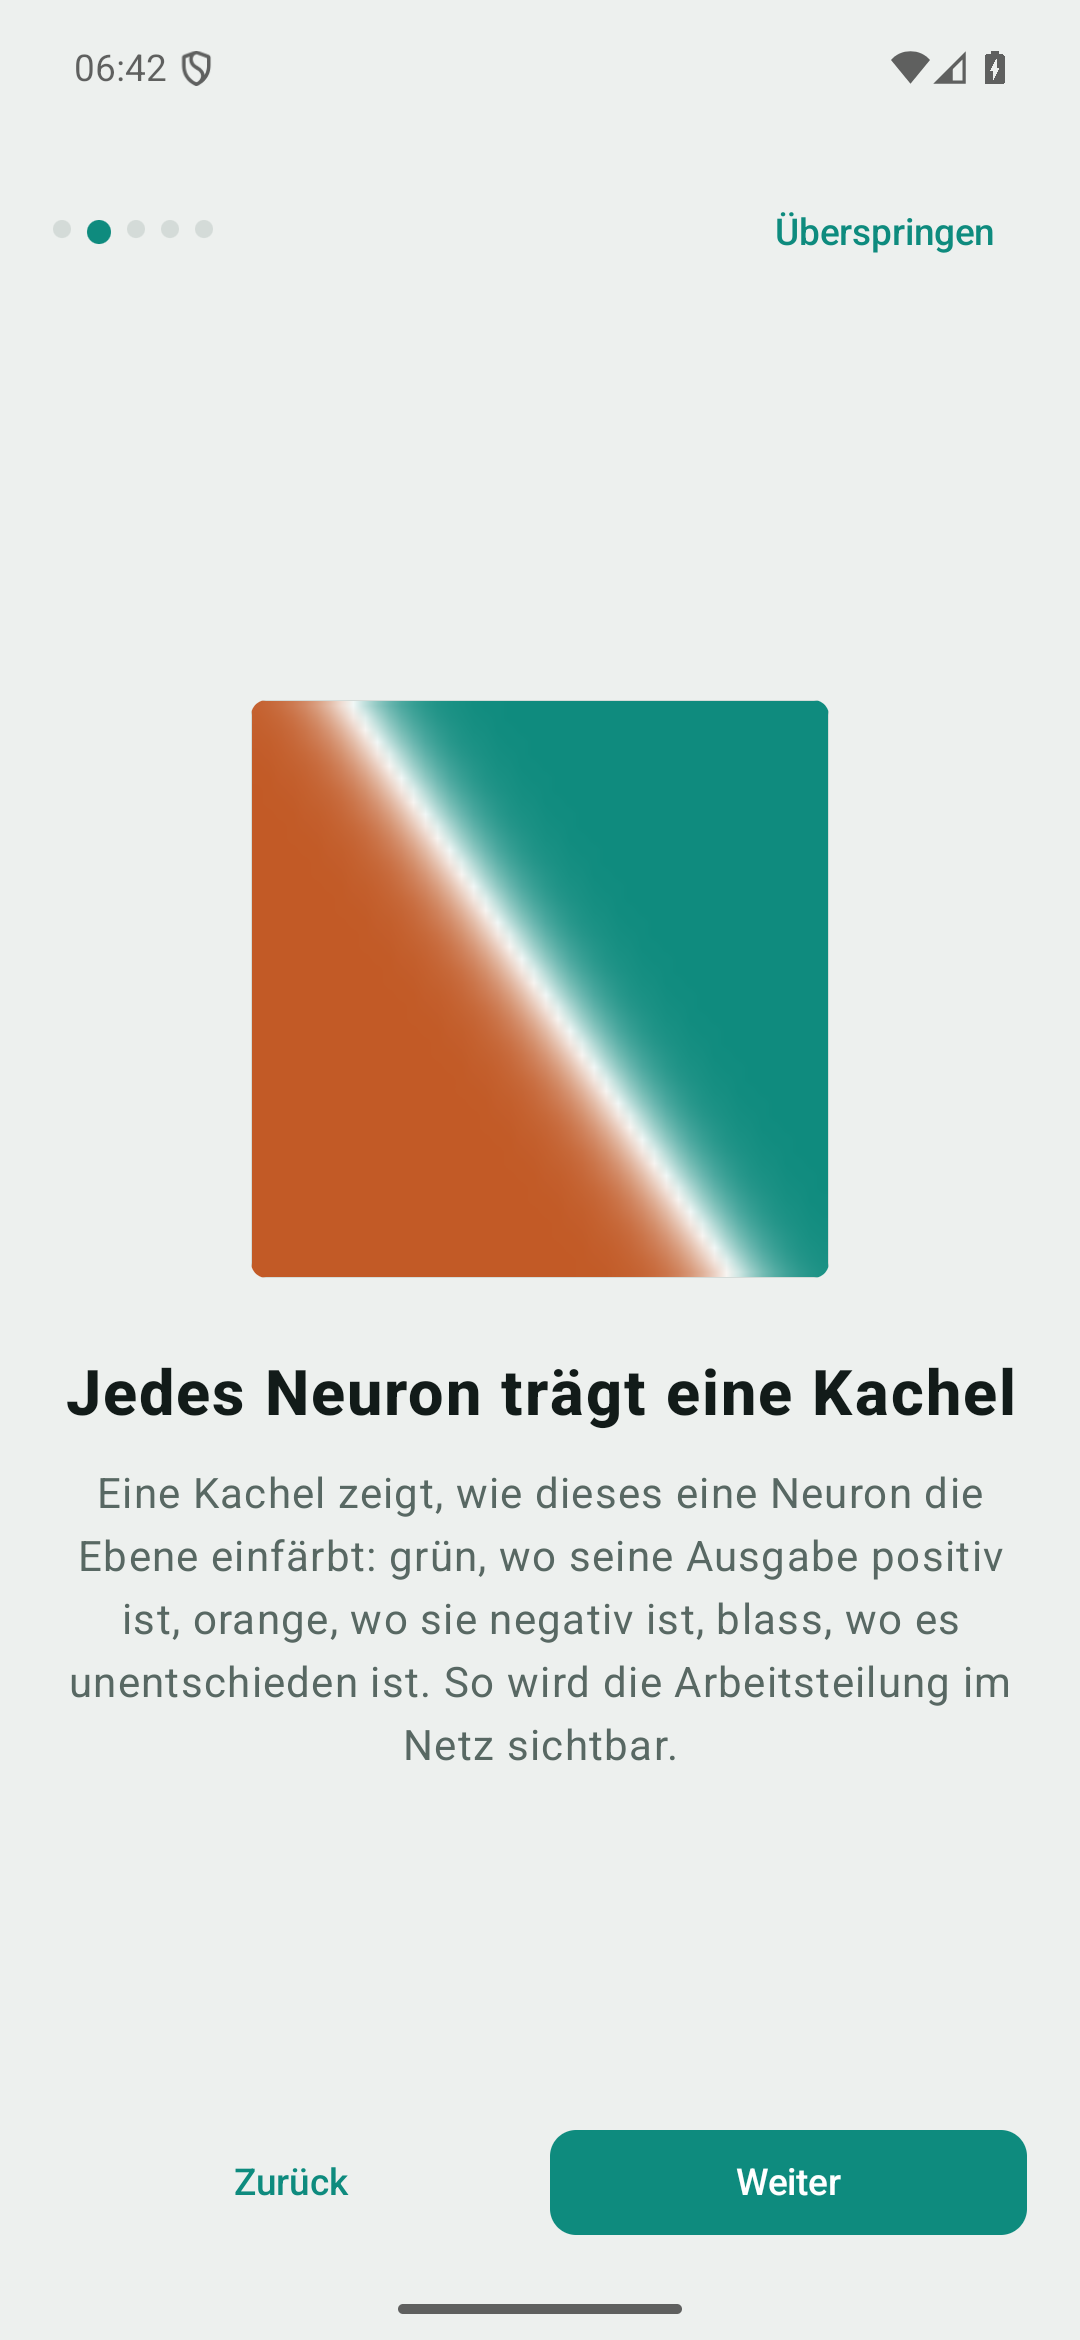
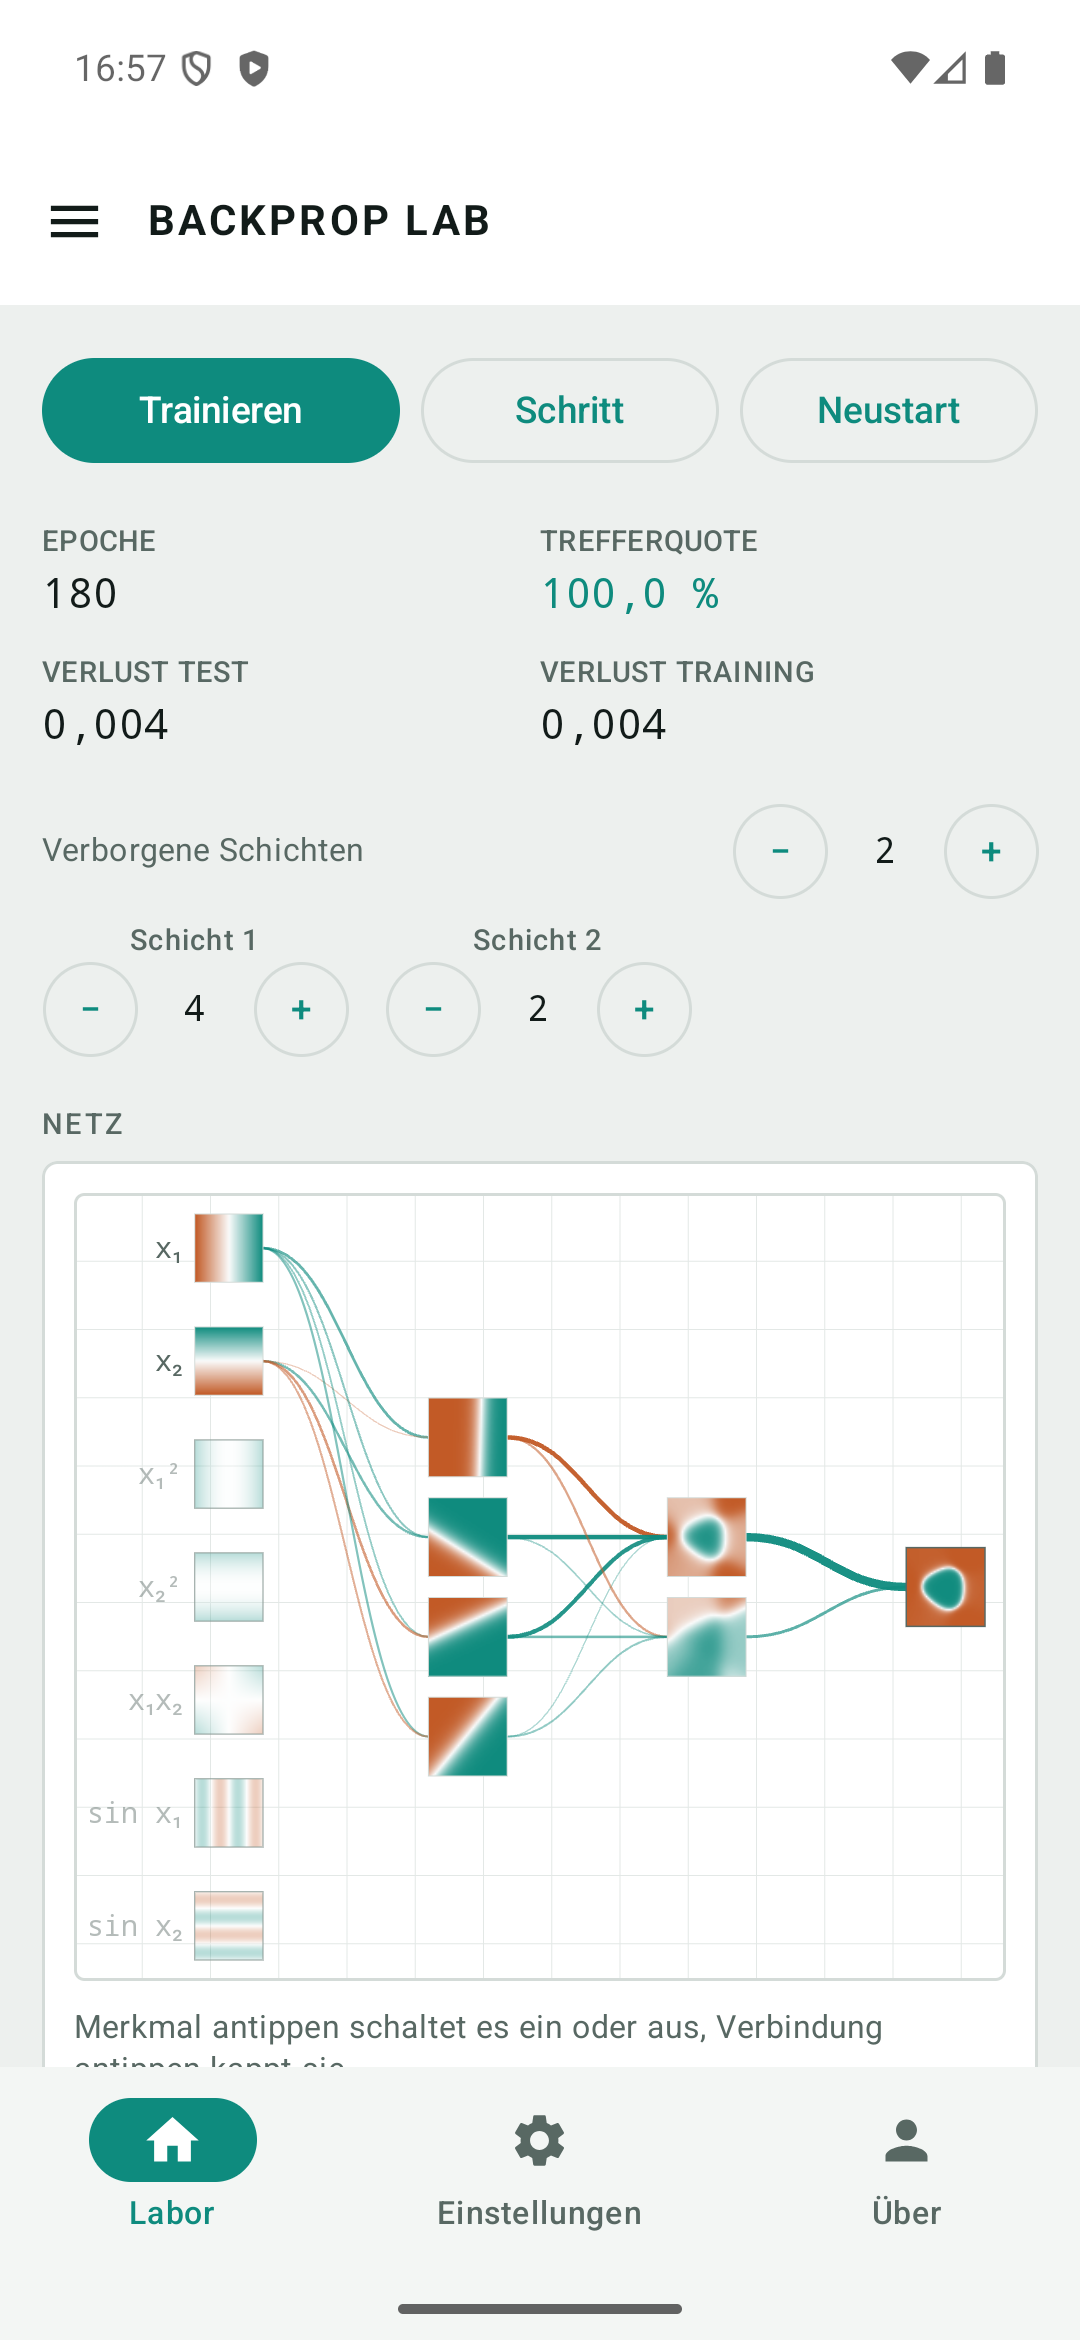
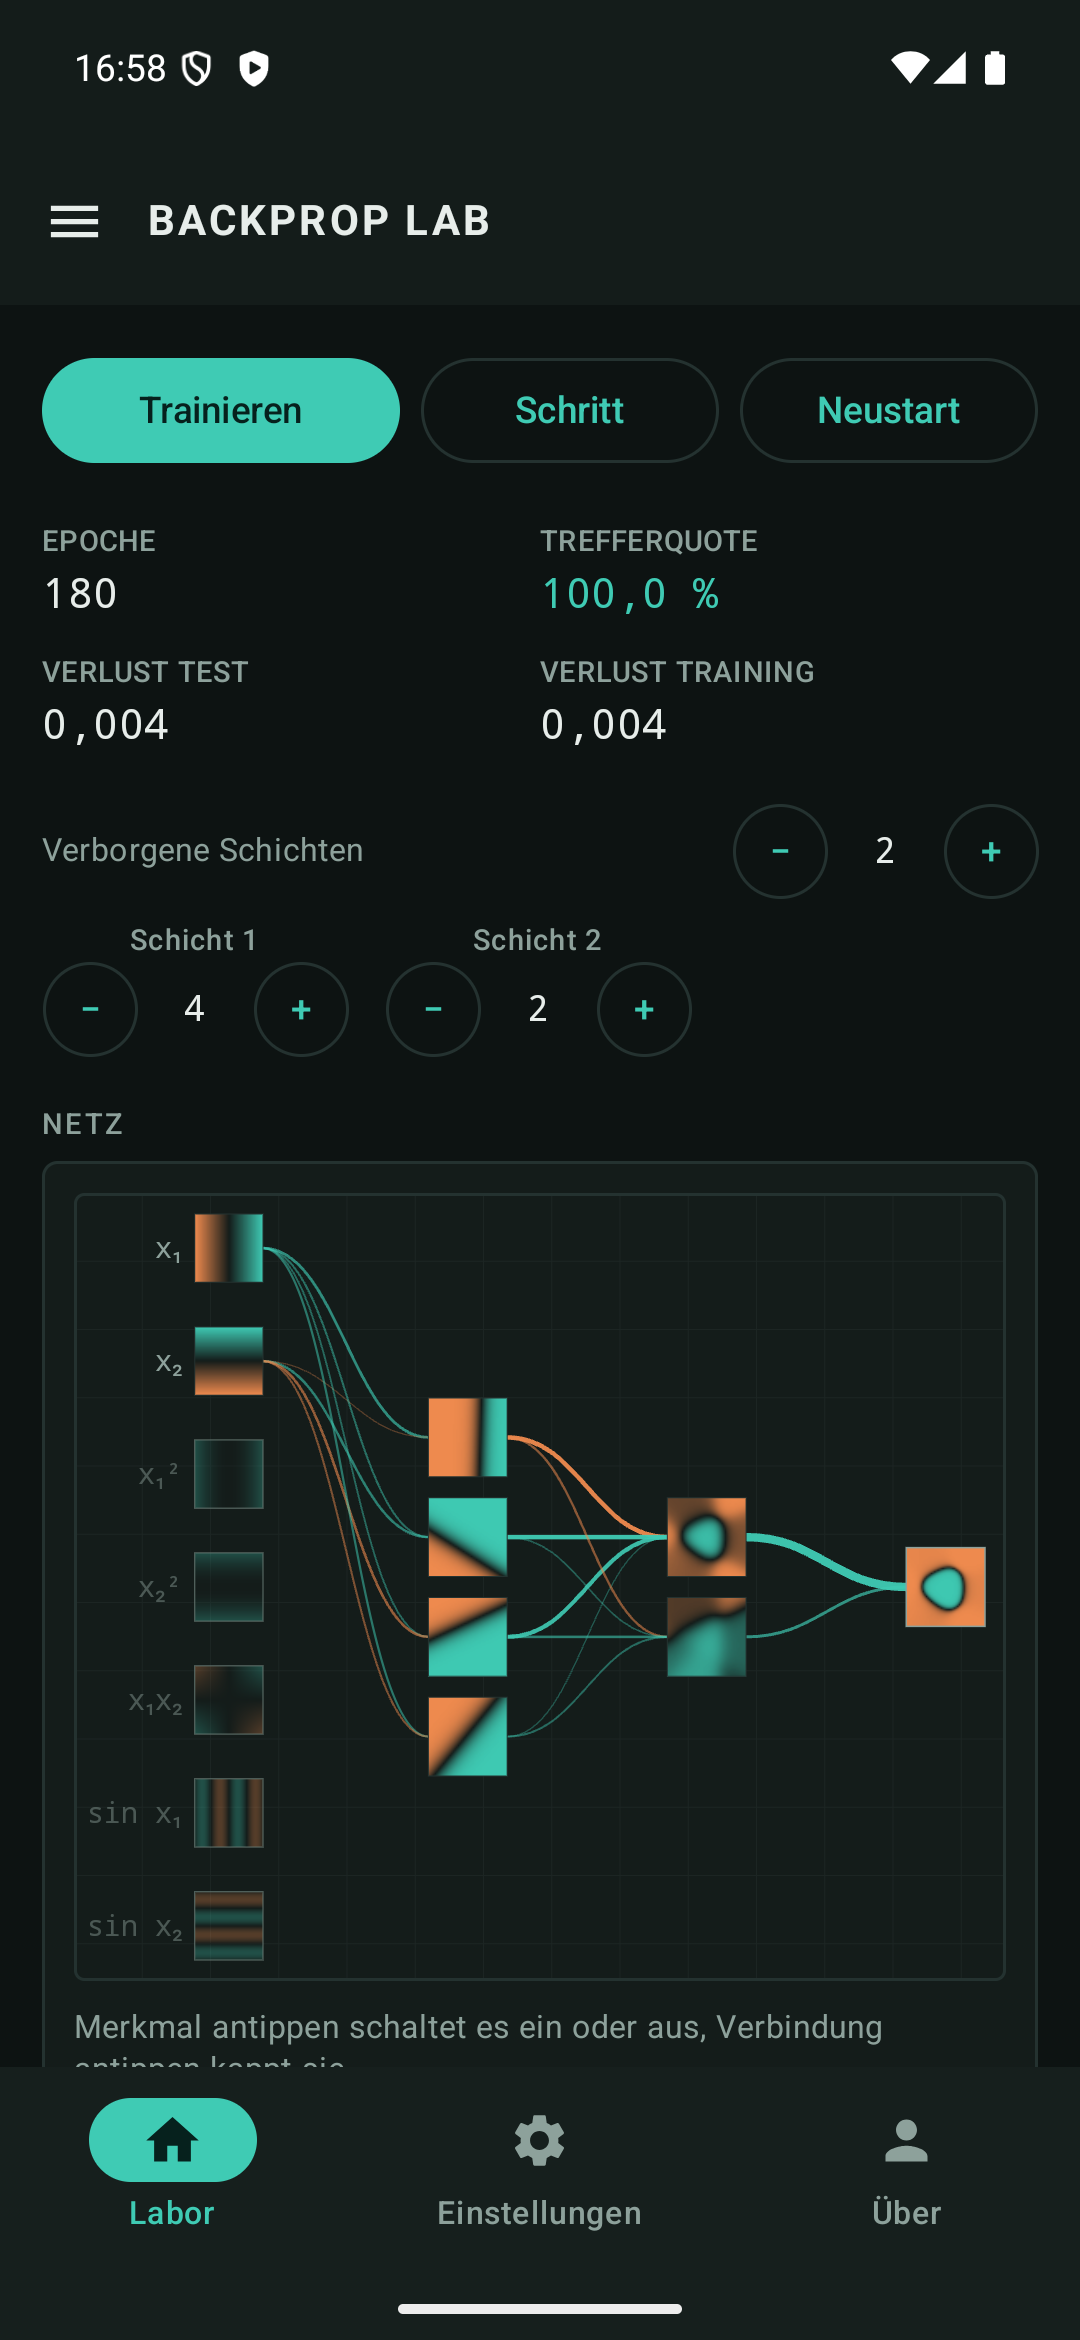
Jede Kachel zeigt, wie dieses eine Neuron die Ebene einfärbt — nicht seinen Zustand für einen einzelnen Punkt, sondern seine Ausgabe überall. So wird die Arbeitsteilung im Netz sichtbar, statt vermutet zu werden.
Ablesbare Gewichte
An jeder Verbindung ist die Farbe das Vorzeichen des Gewichts und die Strichstärke sein Betrag. Dicke Linien tragen die Entscheidung; eine blasse trägt so gut wie nichts.
Eine Verbindung kappen
Ein Tipp oder Klick auf eine Linie trennt sie: Sie überträgt nichts mehr und wird nicht weiter trainiert. Bei einer dicken mitten im Training springt der Verlust hoch — und man sieht zu, wie die übrigen Neuronen die Aufgabe untereinander neu aufteilen.
Die Entscheidungsfläche
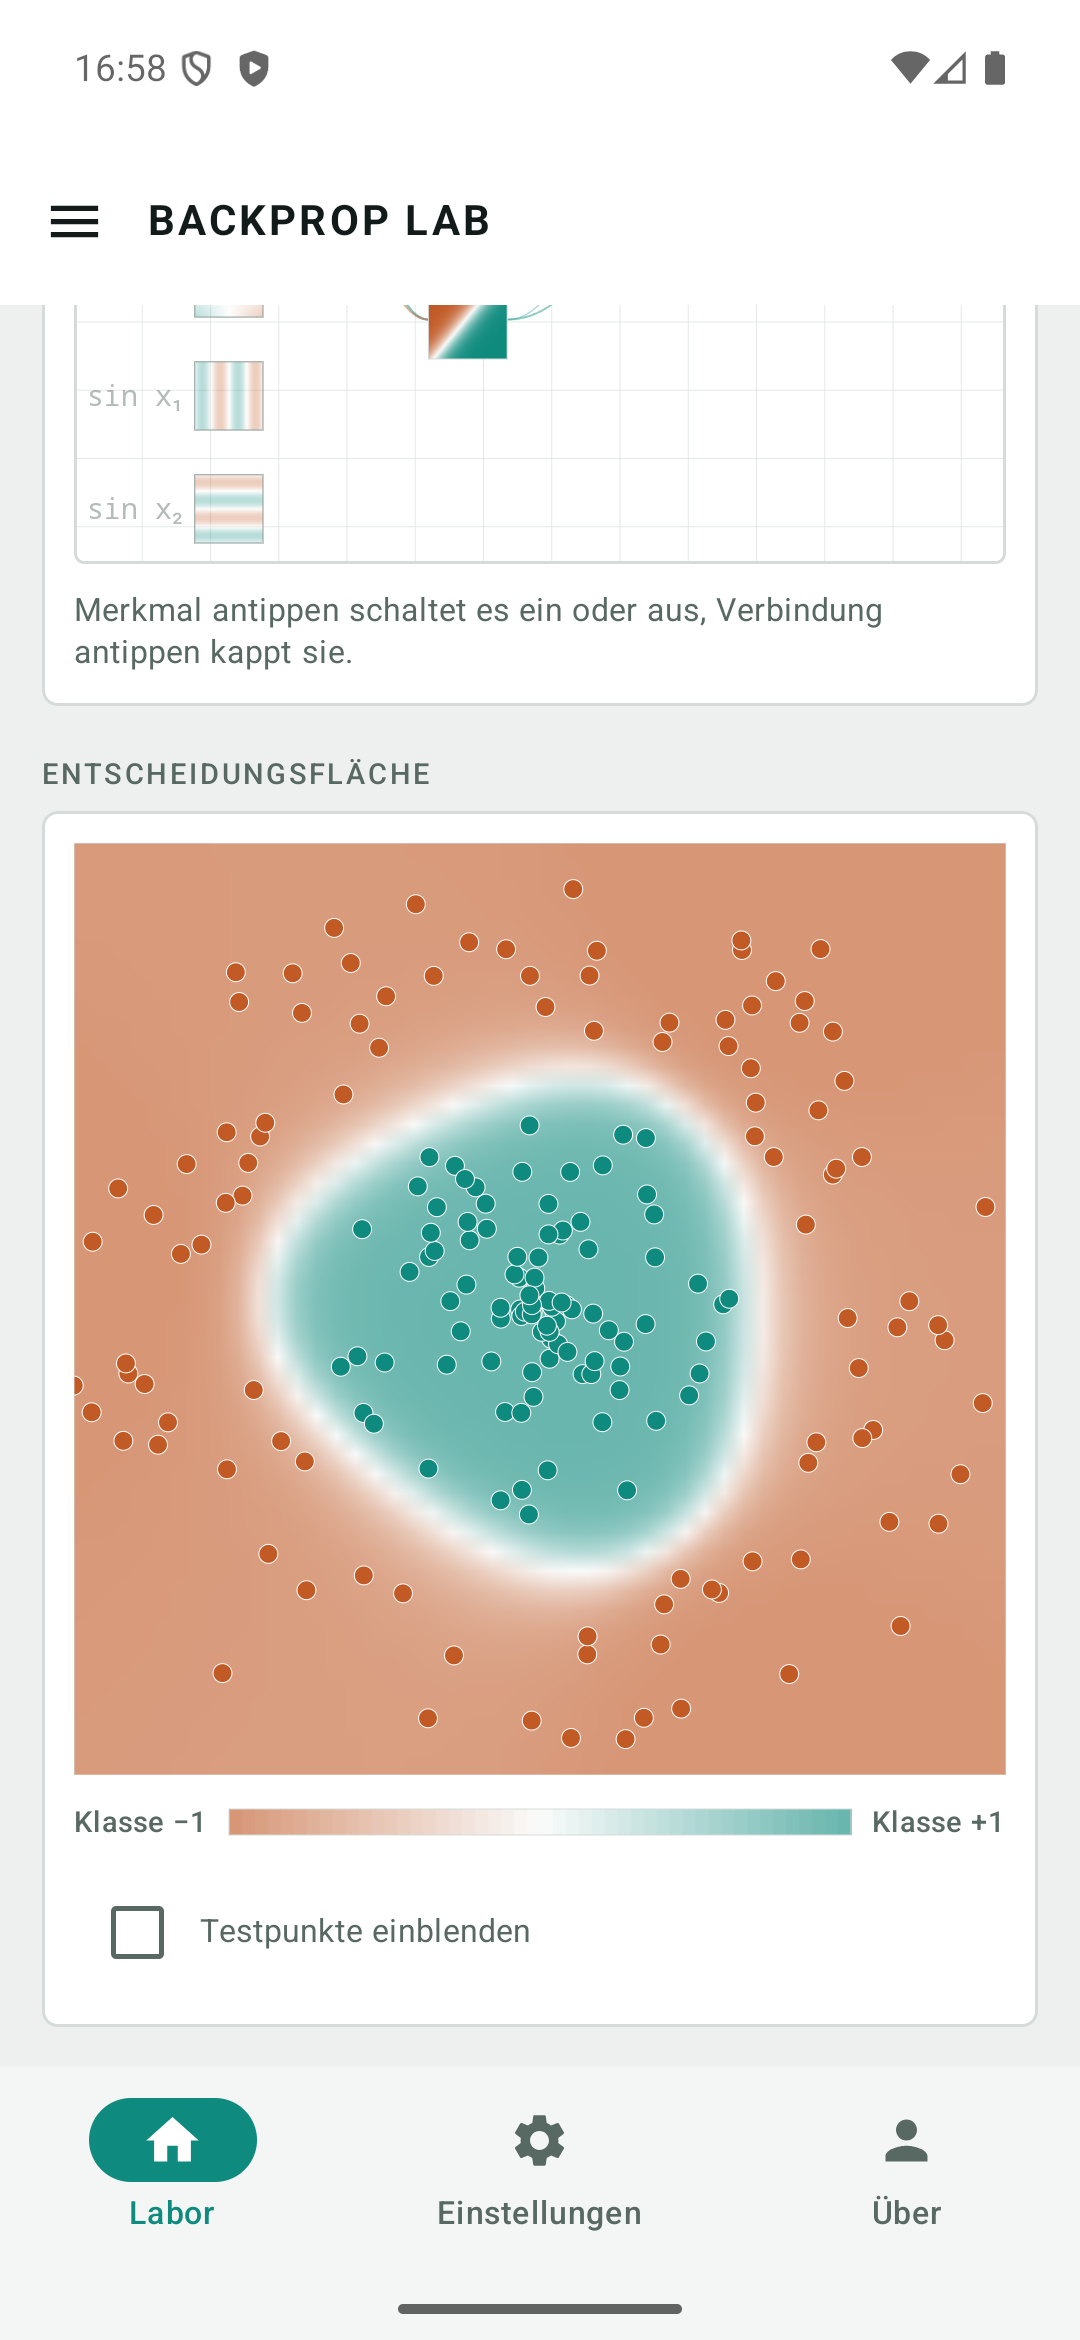
Wie das Netz die ganze Ebene beurteilt, auch dort, wo gar keine Punkte liegen. Gefüllte Punkte sind Trainingspunkte, Ringe die zurückgehaltenen Testpunkte.
Überanpassung beim Entstehen
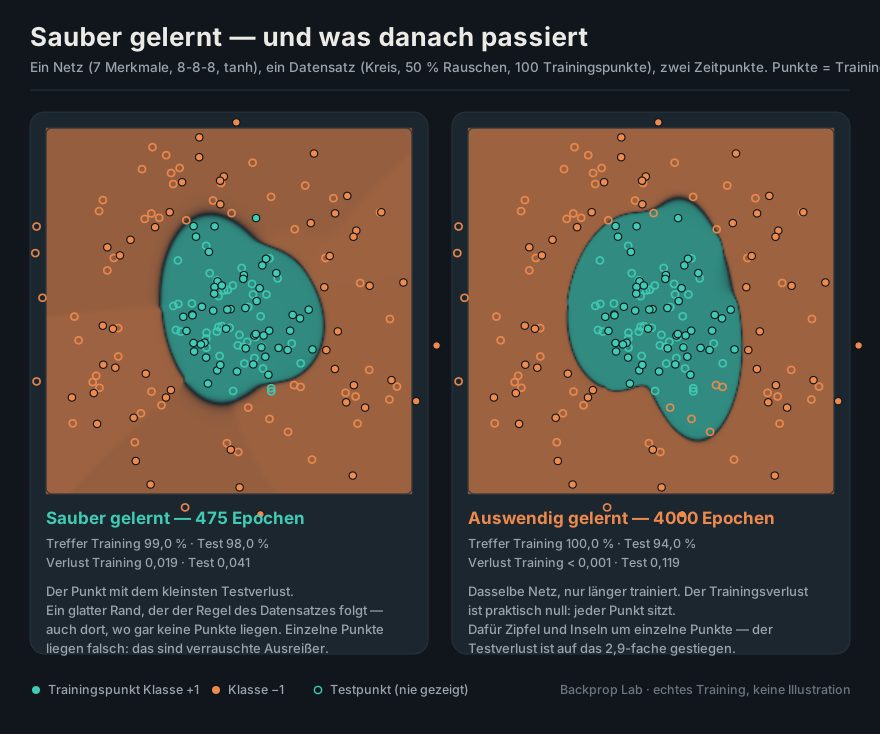
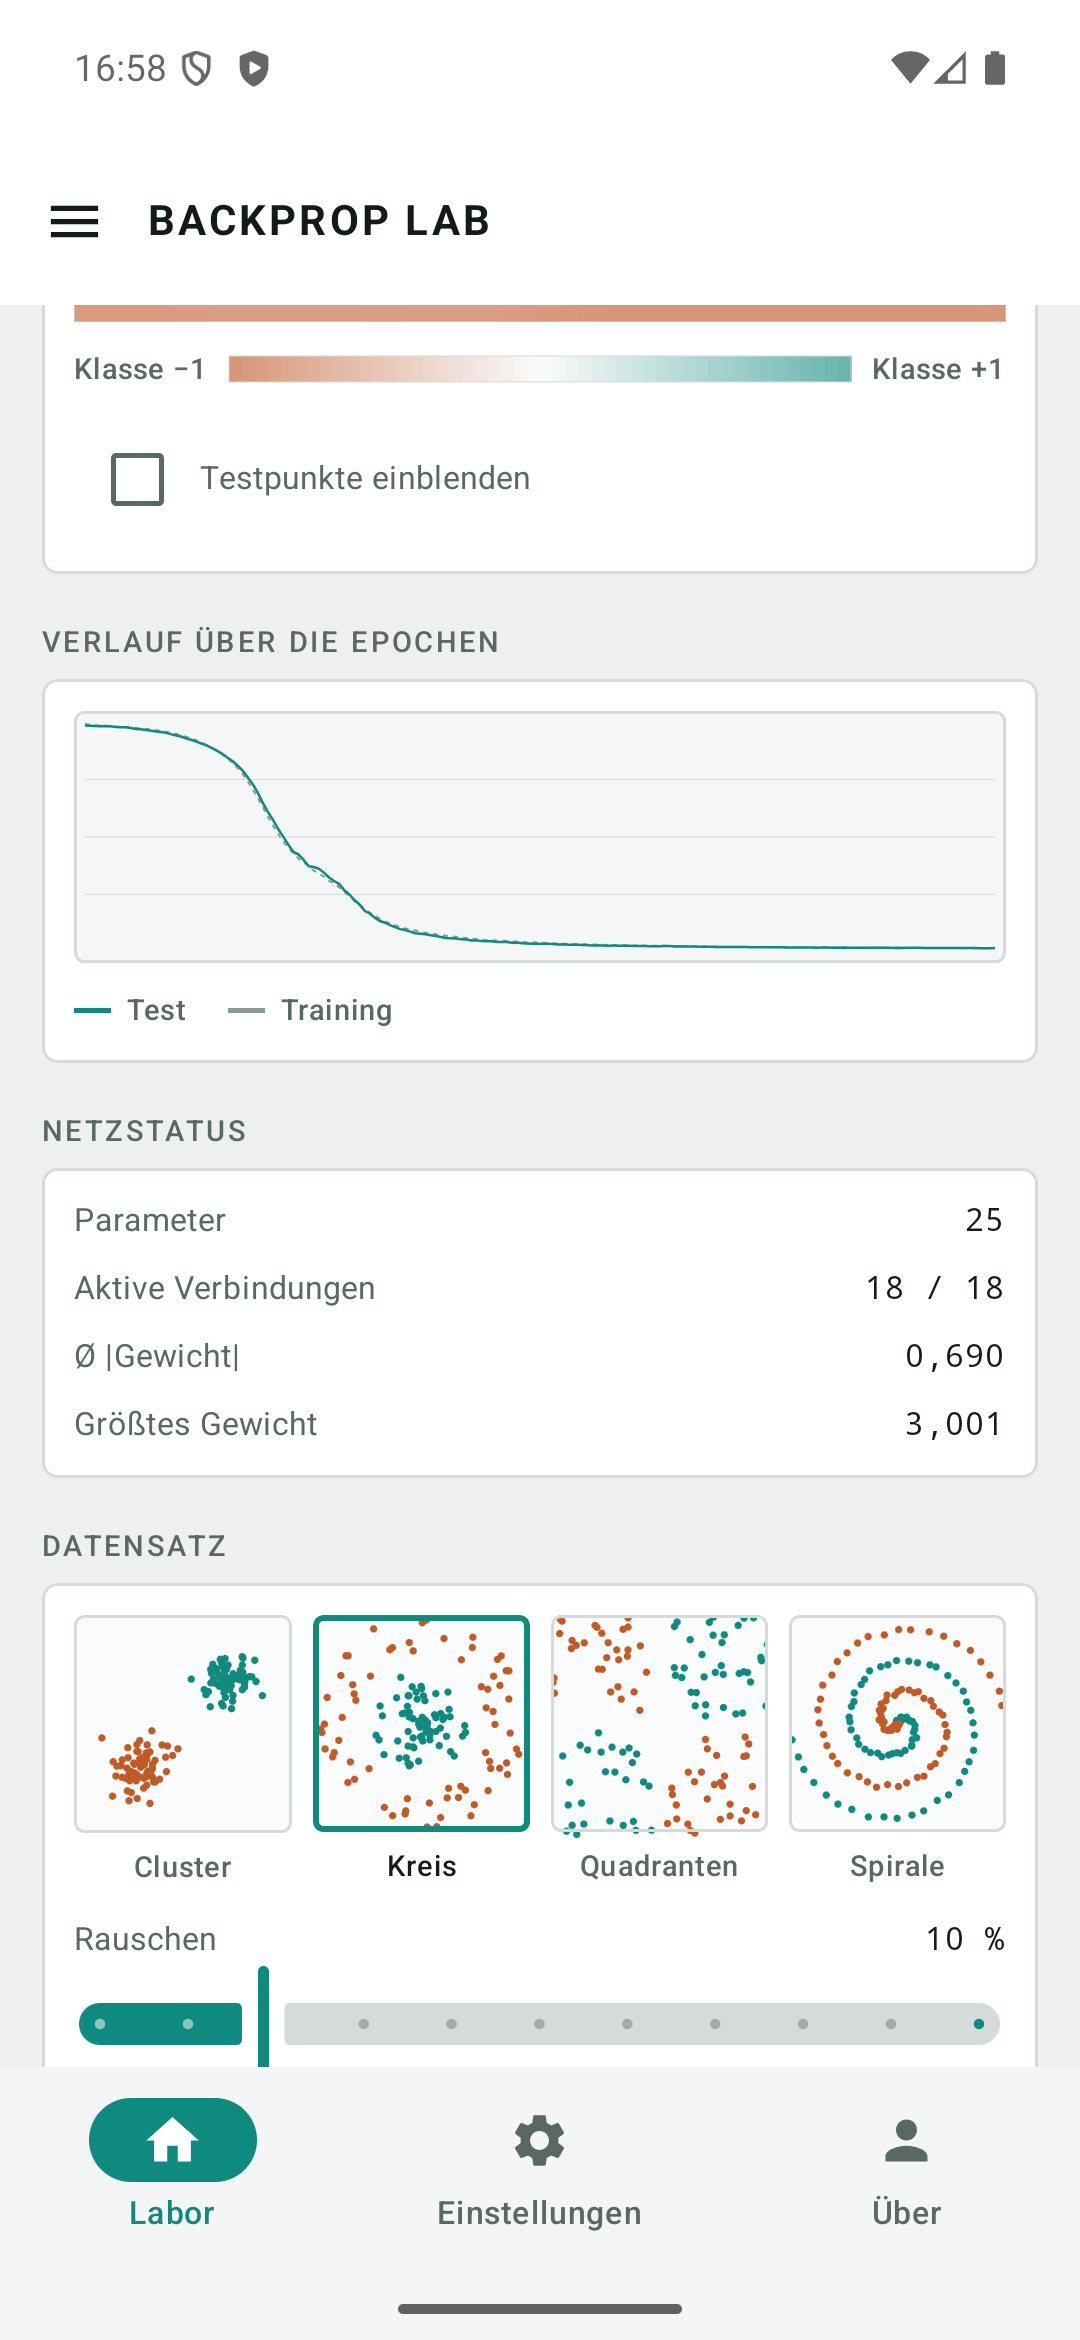
Die Verlustkurve läuft für Trainings- und Testdaten getrennt. Fällt die graue weiter, während die grüne wieder steigt, lernt das Netz die Stichprobe auswendig statt die Regel.
Echt gerechnet, nicht animiert
Mini-Batch-Gradientenabstieg auf ½(o−t)² mit Etiketten ±1. Jede Epoche geht die Trainingspunkte wirklich durch, bildet Gradienten und ändert die Gewichte. Nichts ist vorberechnet.
Merkmale von Hand
Neben x₁ und x₂ stehen Quadrate, das Produkt und Sinus zur Wahl.
Gibt man dem Netz x₁² und x₂², löst es den Kreis ganz ohne
verborgene Schicht — Feature Engineering und Deep Learning nebeneinander.
Drei Wege, es laufen zu lassen
Der Simulator im Browser ist eine einzelne HTML-Datei ohne Bibliothek und ohne Aufbaustufe. Die Android-App ist eine eigene Fassung in Kotlin und Compose, die App für iPhone, iPad und Mac eine in Swift und SwiftUI — gleiche Formeln, gleiche Datensätze, gleiche Farbskala. Alle drei sprechen Deutsch und Englisch.
Zehn Minuten, die sich lohnen
Jeder Schritt zeigt genau eine Sache. Warum sie jeweils passiert, erklärt die Einführung.
Zurücksetzen, dann Trainieren. Zusehen, wie aus dem zufälligen Farbnebel ein Kreis wird. Das ist der ganze Vorgang in dreißig Sekunden.
Aktivierung auf linear stellen. Drei Schichten mit acht Neuronen, noch einmal trainieren — es bleibt bei einer Geraden. Ohne den Knick bringt Tiefe nichts.
Lernrate auf 1 hochdrehen. Die Verlustkurve springt: Die Schritte übersteigen das Tal jedes Mal.
Auf die Spirale wechseln. Vier Neuronen scheitern. Schichten und Neuronen hinzufügen, bis es klappt — so fühlt sich Kapazität an.
Während des Trainings eine dicke Verbindung kappen. Der Fehler springt, und das Netz ordnet sich binnen Sekunden neu.
Rauschen auf 50 %, Testpunkte einblenden, lange trainieren. Der Rand wird zipfelig, die Testkurve steigt: Überanpassung, gesehen statt beschrieben.
Datensätze
Vier Aufgaben, aufsteigend nach Schwierigkeit. Interessant ist nicht, dass das Netz sie löst, sondern was es dazu braucht.
| Datensatz | Regel | Was es braucht |
|---|---|---|
| Cluster | Zwei Gauß-Wolken, diagonal gegenüber. | Eine gerade Linie — ohne verborgene Schicht. |
| Kreis | Innen die eine Klasse, außen der Ring. | Eine verborgene Schicht oder die Merkmale x₁² und x₂². |
| Quadranten | Klasse nach dem Vorzeichen von x₁·x₂. | Das klassische XOR-Problem; mit x₁x₂ trivial. |
| Spirale | Zwei ineinander gedrehte Arme. | Mehrere Schichten, viele Neuronen, Geduld. |
Das Rauschen verschiebt die Punkte, bevor das Etikett vergeben wird; bei 50 % liegen deshalb einige auf der falschen Seite — 100 % Trefferquote sind dann nicht erreichbar, und wer es trotzdem erzwingt, lernt das Rauschen auswendig. Die Hälfte aller Punkte wird als Testmenge zurückgehalten und dem Netz nie gezeigt.
Zwei Texte
Einführung
Für alle, die mit neuronalen Netzen noch nichts zu tun hatten. Neuron, Gewicht, Bias, der Knick in der Aktivierung, Verlust, Gradientenabstieg und Backpropagation — von vorn erklärt, mit Diagrammen und einer Übung am Gerät.
Handbuch
Siebzehn Abschnitte: jeder Regler, die vier Datensätze, die sieben Merkmale, die tatsächlich gerechneten Formeln, fünf Experimente, eine Tabelle zur Fehlersuche und die Apps für Android sowie für iPhone, iPad und Mac.
Hilfe
Die kurzen Antworten — dieselben Fragen, die die App auf dem Gerät mitbringt, dazu die, die nur im Browser auftauchen.
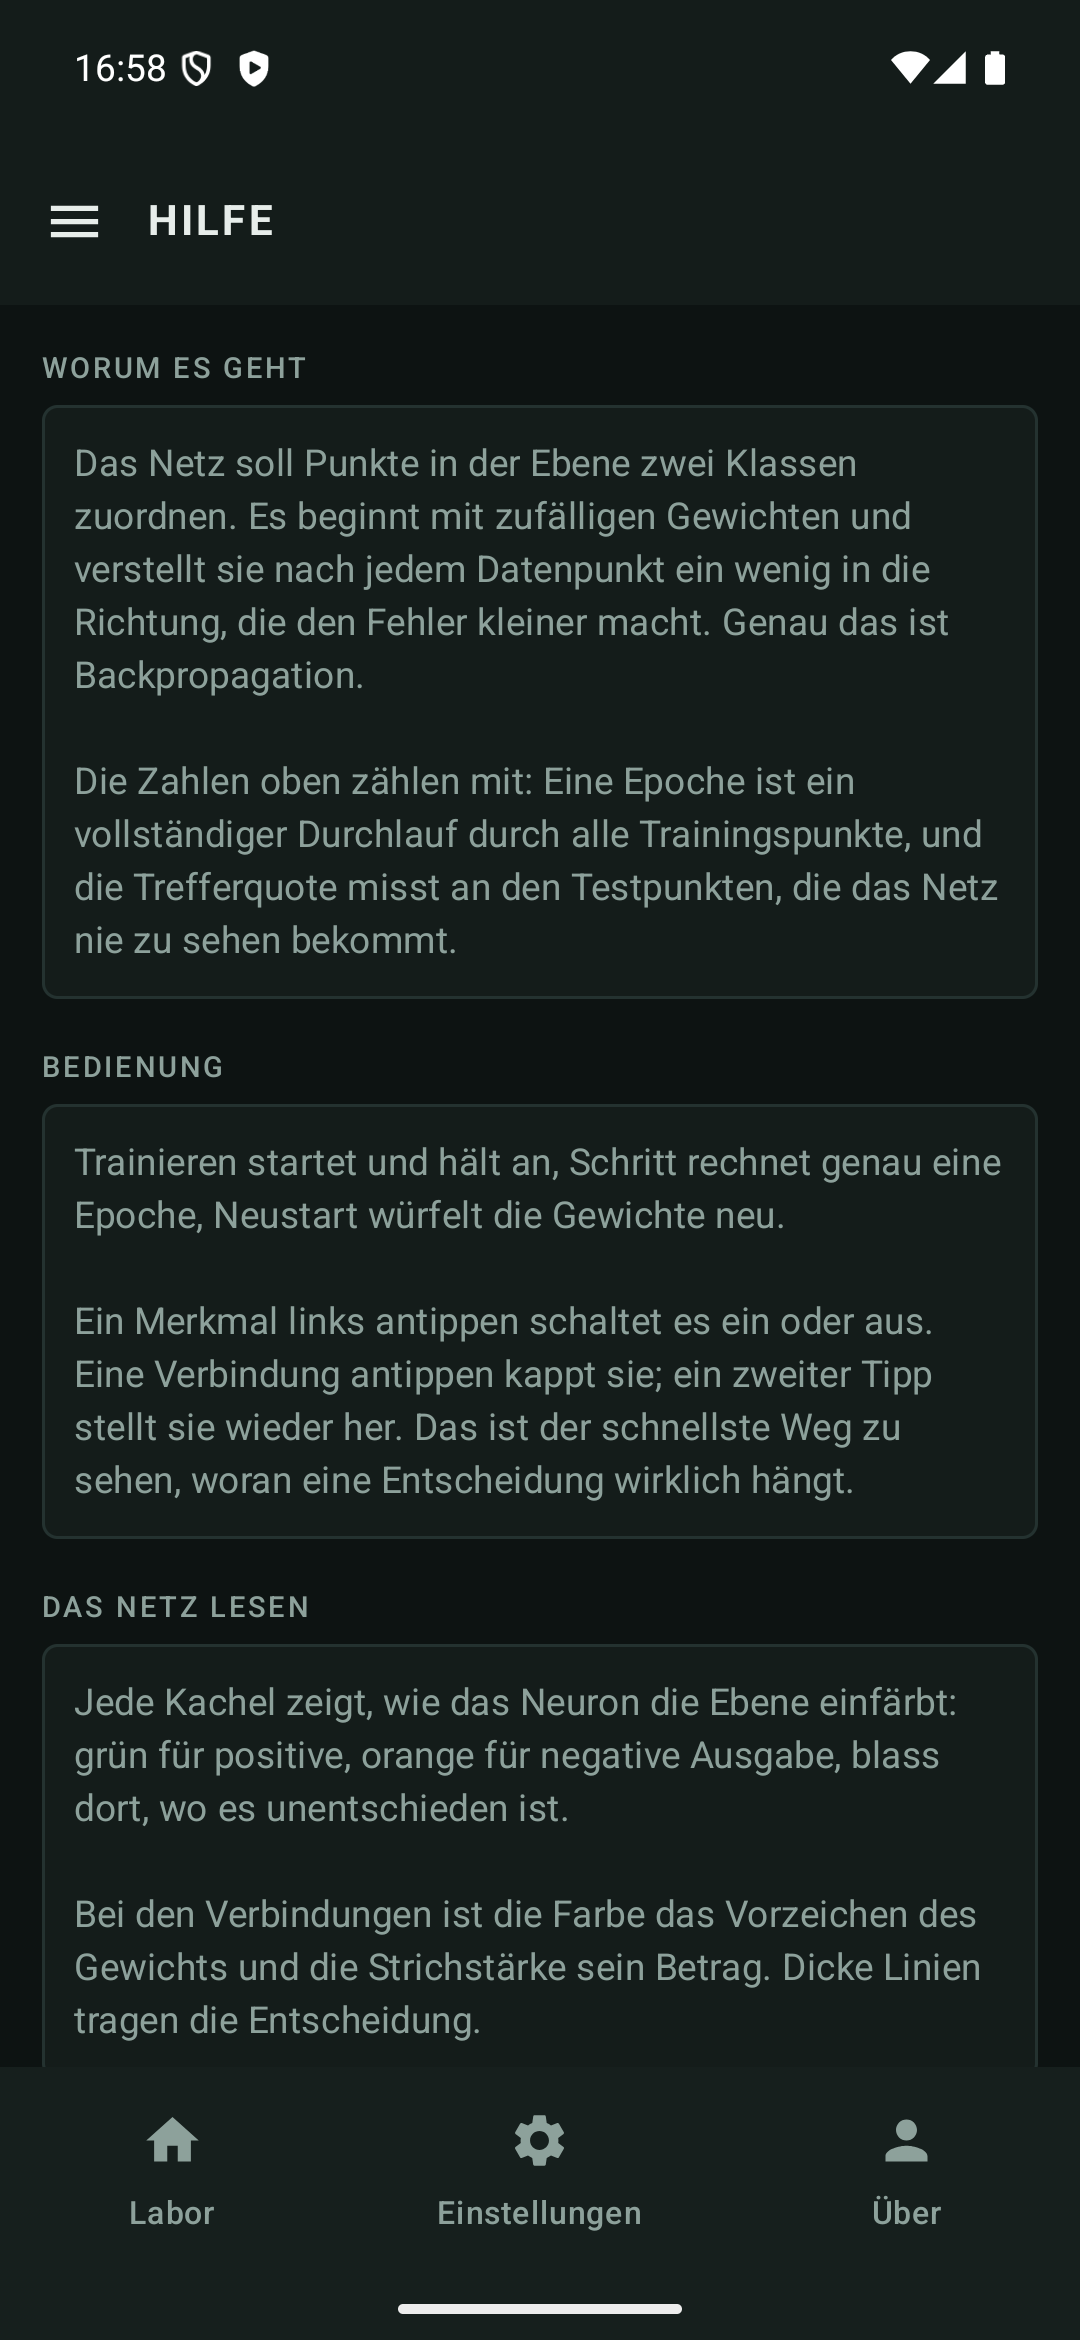
Screenshots
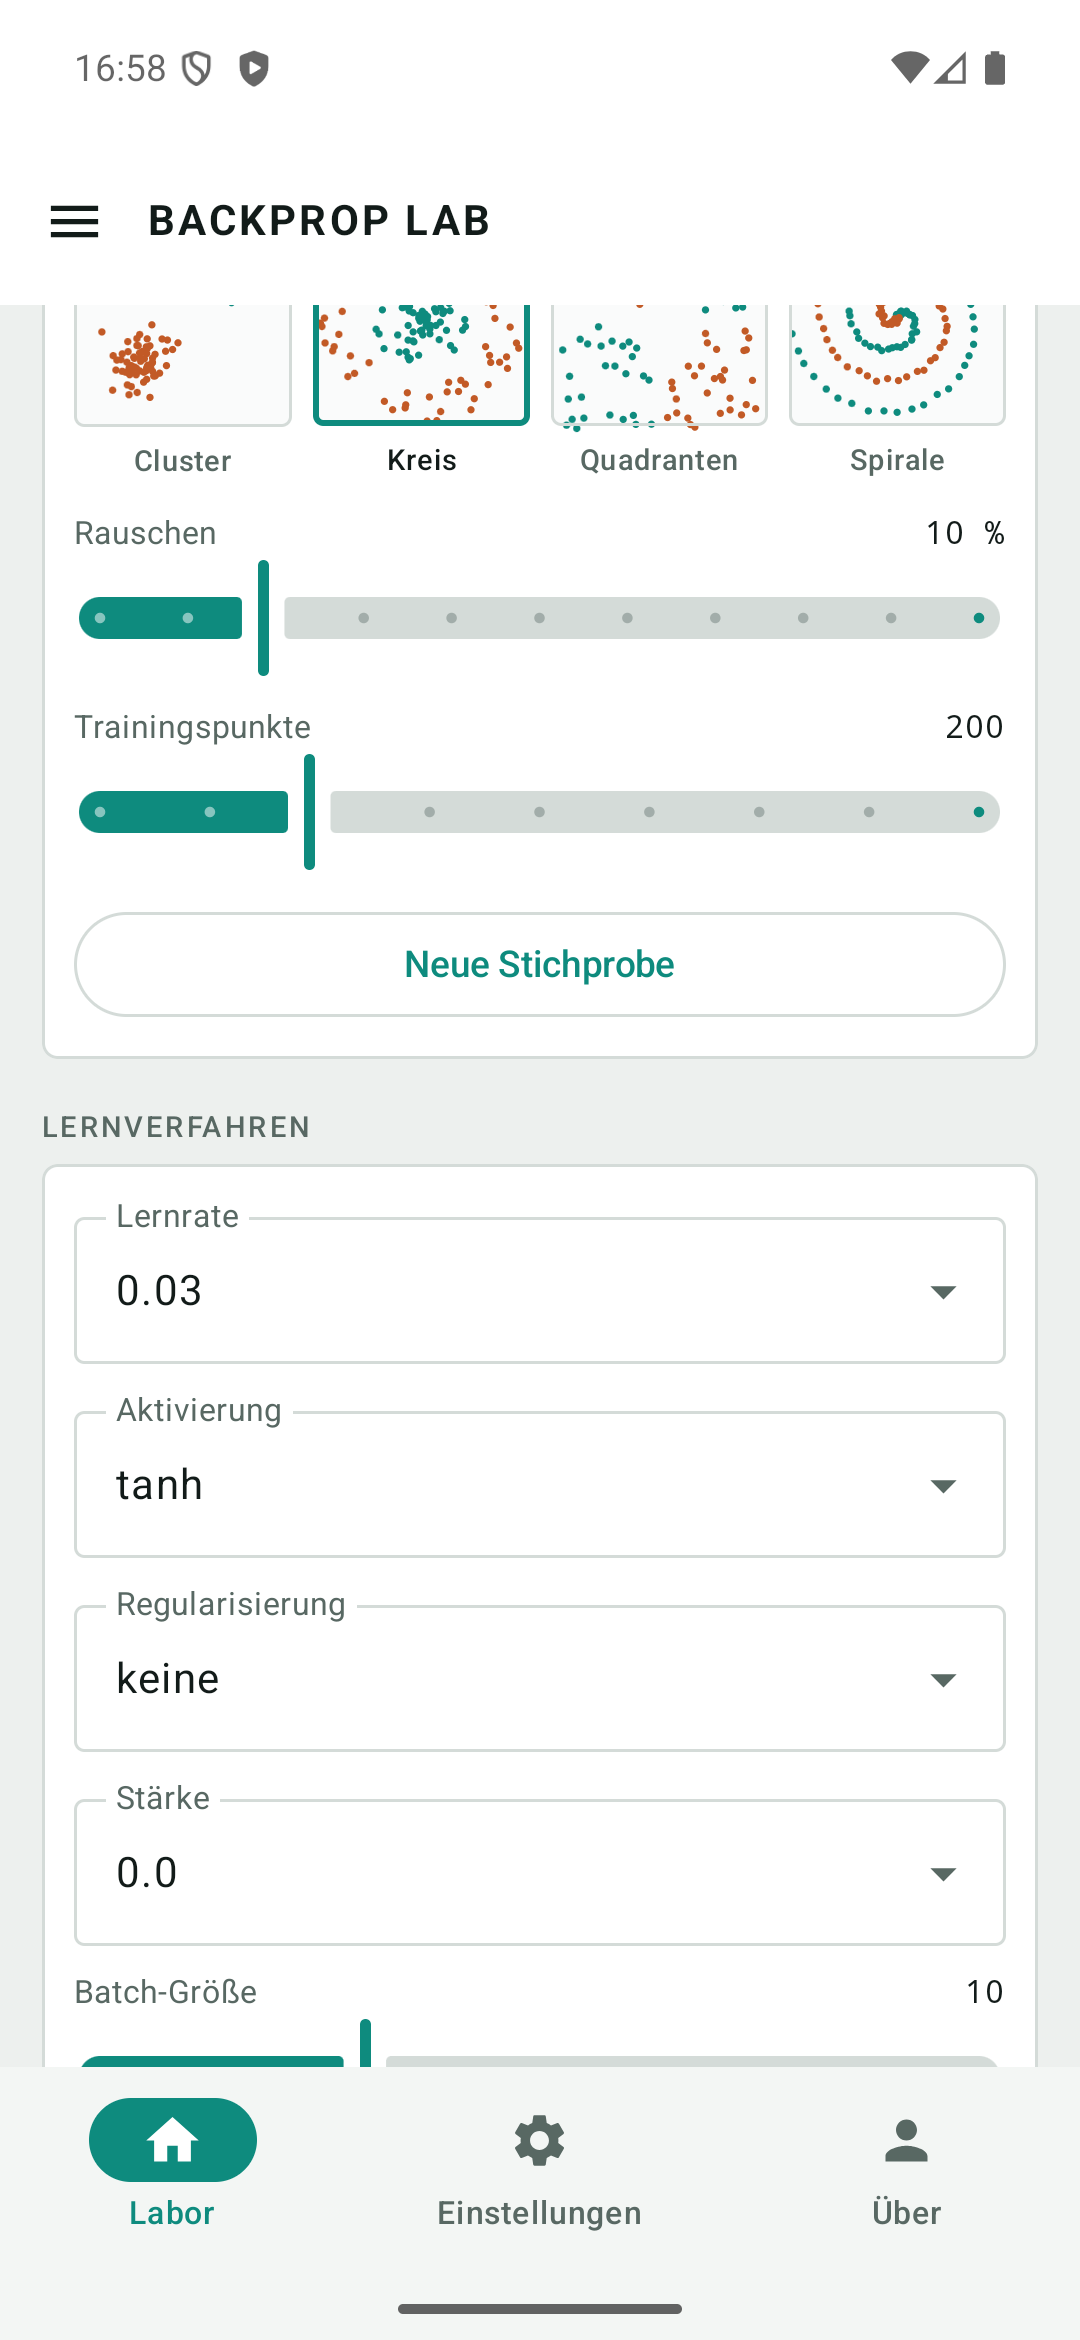
Aus der Android-App, aufgenommen auf einem Telefon mit 1080 × 2340.
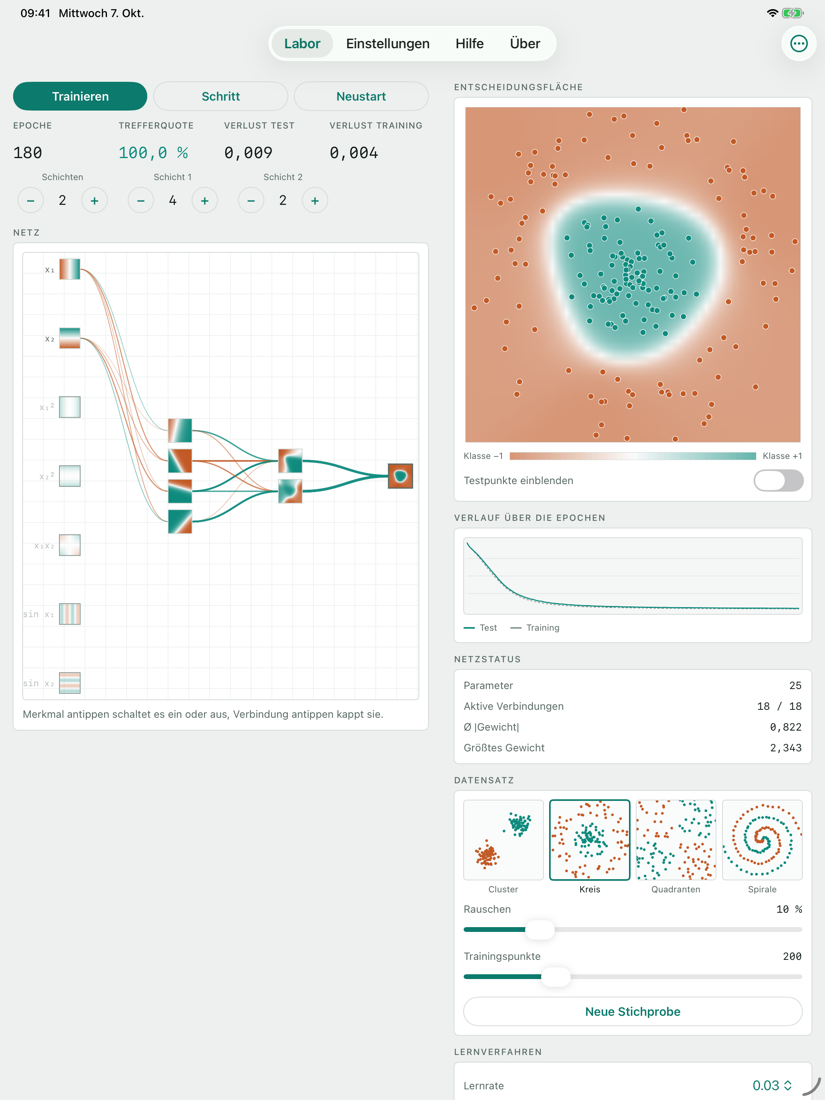
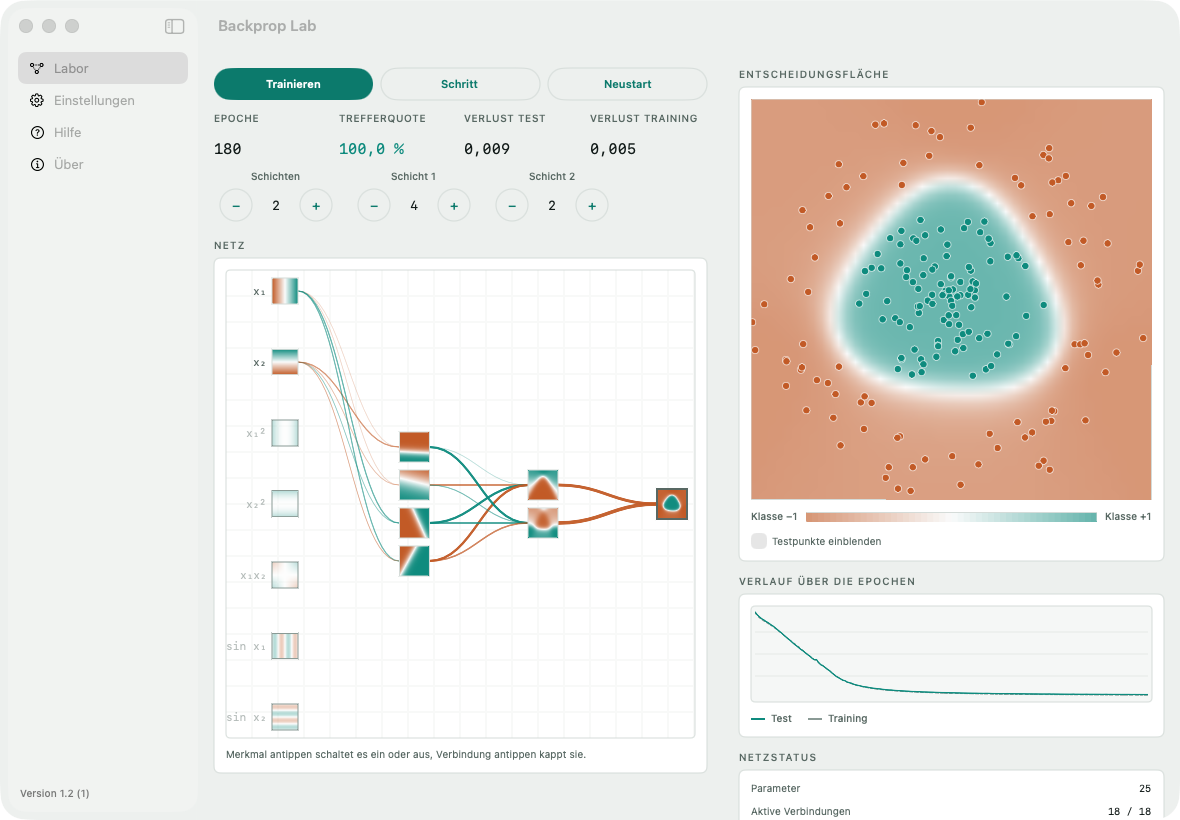
Auf iPad und Mac
Dieselbe App zweispaltig: links das Netz, rechts Fläche, Verlauf und Regler. Auf dem Mac mit Seitenleiste, Menü und Tastenkürzeln.
Datenschutz in einem Absatz
Backprop Lab behält nichts über Sie. Die Android-App fordert überhaupt keine Berechtigungen an — nicht einmal Internet, sie kann also gar nichts übertragen. Die App für iPhone, iPad und Mac fragt ebenso nach keiner Berechtigung und baut von sich aus keine Verbindung auf. Gespeichert werden nur ein paar Einstellungen — die gewählte Sprache und Darstellung, ob die Einführung gesehen wurde, und ein Startzähler für die einmalige Bitte um eine Bewertung —, im privaten Bereich der App auf dem Gerät und beim Deinstallieren mitgelöscht. Die Datenpunkte entstehen bei jedem Start neu per Zufallsgenerator. Die Browser-Fassung merkt sich einen einzigen Wert, die gewählte Sprache; ihre einzige Anfrage nach außen holt die Schriftarten. Keine Konten, keine Werbung, keine Analyse, keine Absturzberichte. Der vollständige Text steht in der Datenschutzerklärung.